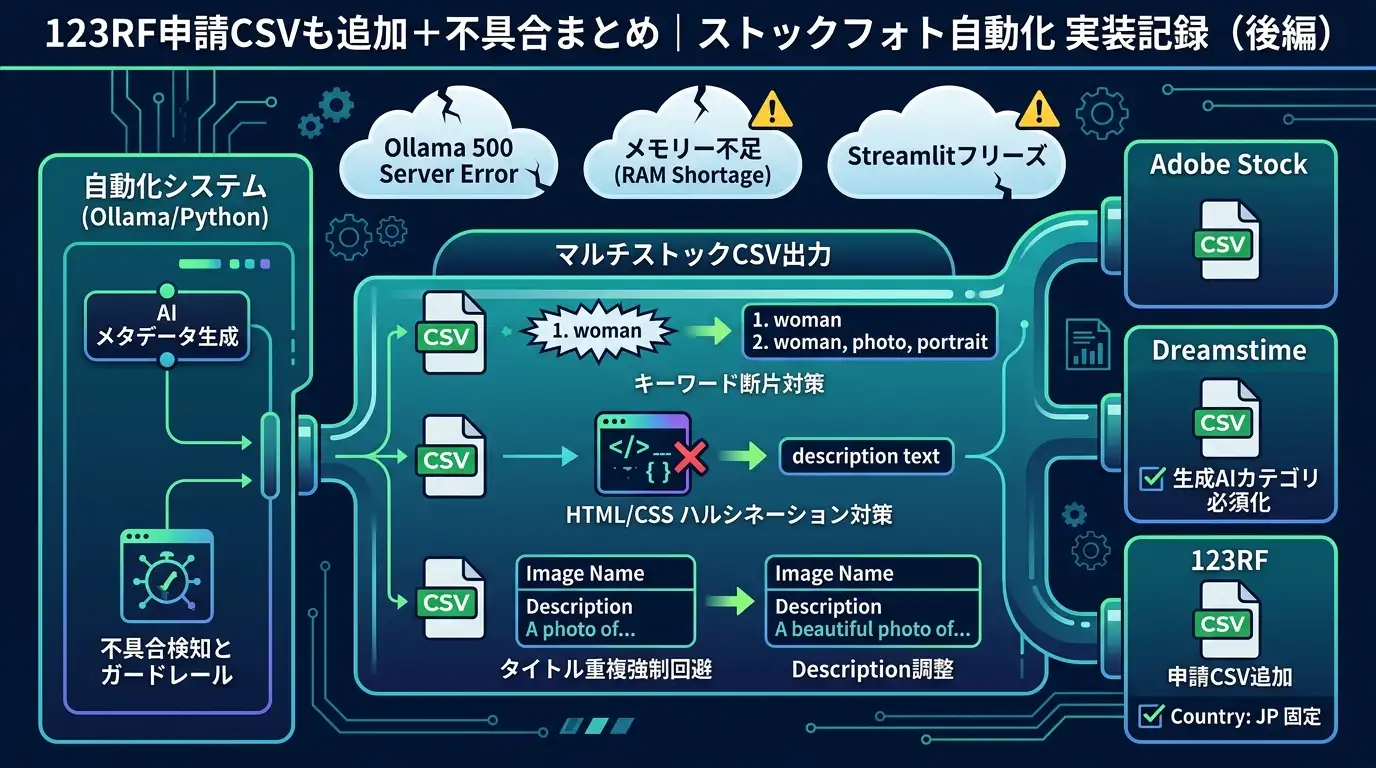
前編(0031)では、Adobe Stock申請用CSVの生成処理を拡張し、Dreamstime申請用CSVも同時出力できるようにしました。 本記事はその続きとして、123RF申請用CSVの追加と、実際に画像・動画を大量処理していく中で見つかった キーワード生成・タイトル生成まわりの不具合、そしてOllamaサーバー自体が落ちた実例までをまとめて記録します。 1つ1つは小さな修正ですが、積み重なるとそれなりのボリュームになったため、前編と分けて後編としました。
本記事の位置づけ(0031の続き)
フロー上の位置づけは0031と同じ「④2-6 メタデータ生成」の延長です。処理の骨格(CLIP解析→Ollamaでのメタデータ生成→CSV出力)は変わらず、 出力するCSVの種類と、生成品質のガードレールが増えた形になります。
- Adobe Stock用CSV:
adobe_stock_upload.csv/_video.csv(既存) - Dreamstime用CSV:
adobe_stock_upload_dreamstime.csv/_video.csv(0031で追加) - 123RF用CSV:
adobe_stock_upload_123rf.csv/_video.csv(今回追加)
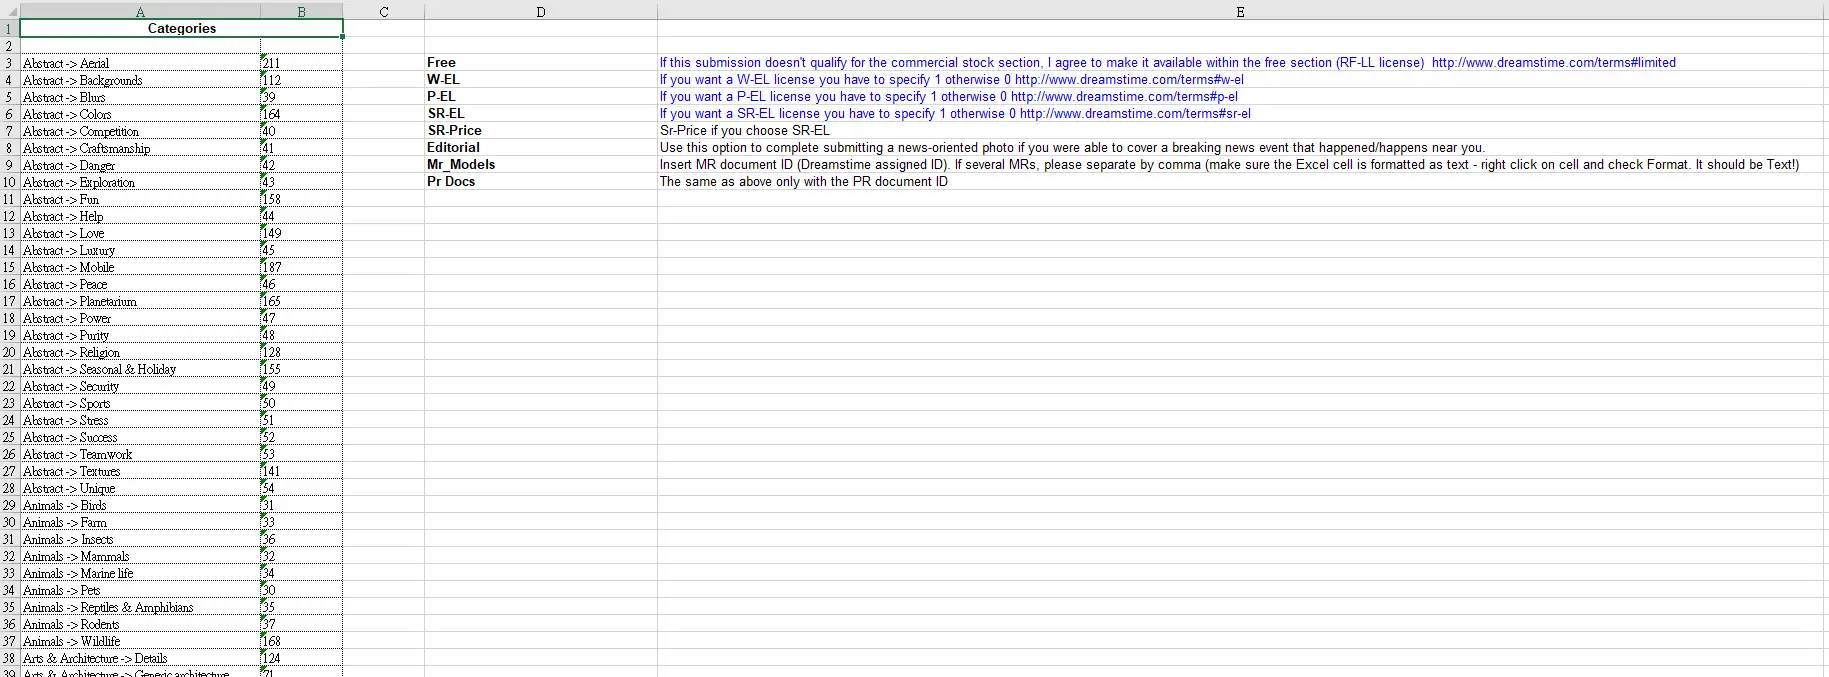
実際には下図のようにCSVが作成されます。
123RF申請用CSVを追加
123RFのCSVテンプレートは、Dreamstimeよりもさらにシンプルな構成でした。
| 列名 | 内容 |
|---|---|
| oldfilename | 元のファイル名(識別用) |
| 123rf_filename | アップロード時にリネームするファイル名 |
| description | 説明文(123RFにはタイトル欄が別途無い) |
| keywords | キーワード(カンマ区切り) |
| country | 申請者の国コード |
カテゴリ列が存在しないため、Dreamstimeで作り込んだカテゴリの判定ロジックはここでは使いません。
実装で悩んだのは123rf_filenameの付け方でした。123RF側の命名規則が不明だったため、
「元のファイル名をそのまま使う(スペースや括弧は安全な文字に置換)」という方針にし、
oldfilenameと123rf_filenameには同じ値を入れています。
ファイル名サニタイズの例
0507 (23).jpg→0507_2320260823_001.jpg→20260823_001
description欄には、Dreamstime同様に元のタイトル生成結果をそのまま使用しています。
country欄はstockphoto.jsonのrf123_defaultsで固定値(JP)を設定できるようにし、
Dreamstimeのライセンス初期値と同じ考え方でJSON側に集約しました。
運用ログ①:キーワードが「文章の断片」になる問題
123RF・Dreamstime双方のCSVを実際にアップロードしてみると、キーワード欄がほぼ空、
あるいは"1. Woman with"のような意味不明な断片になっているケースが見つかりました。
原因は、使用モデル(llava-phi3)が「短いキーワードのカンマ区切りリスト」という指示に従わず、
文章で応答してしまうことでした。当初のコードは4語以上のフレーズを検出すると先頭3語だけ残す
実装になっており、これが中途半端な断片を生み出していました。
対策として、「丸ごと破棄する」でも「無理に短縮する」でもなく、 文章の中からストップワードを除いた実質的な単語を個別キーワードとして抽出する方式に変更しました。
| モデルの応答(抜粋) | 抽出結果 |
|---|---|
| "There are other people in front of windows behind her as well." | people, front, windows, behind |
あわせて、括弧付きの語(white (mirror))の整形や、
フレーズとその構成語が両方リストに残ってしまう重複(zodiacal・signs・zodiacal signsが並存する等)
を解消する後処理も追加しています。この修正はキーワード生成処理そのものへの変更のため、
Adobe Stock用CSVのキーワード列にも同様に反映されます。
運用ログ②:モデルがHTMLタグやCSSをハルシネーションする
さらにテストを重ねると、今度はタイトルの代わりに<img src="https://...">という
架空のHTMLタグが返ってきたり、キーワード欄がまるごと```cssで始まるCSSコードのハルシネーションに
置き換わってしまうケースに遭遇しました。
これまでの不正応答チェックは「英単語が3つ以上あるか」「バッククォートを含むか」しか見ていなかったため、
imgやsrcやhttpsも英単語としてカウントされてしまい、チェックをすり抜けていました。
HTMLタグ・URL・コードフェンス・CSSらしき記号({`}` ;`)の混入を検知する共通チェックを新設し、
タイトル・キーワードの両方に適用することで、こうした応答は無効と判定して再試行、
あるいは丸ごと破棄するようにしています。
運用ログ③:タイトルと説明文が完全一致してしまう抜け穴
Dreamstime申請画面を細かく確認していく中で、まれにImage Name(タイトル)とDescription(説明文)が 一字一句同じになっている行を見つけました。設計上、Image Nameは129文字以内の短文を別プロセスで 生成しているため、通常は自然に異なる文章になるはずでした。
原因は、短縮タイトル生成が失敗した際のフォールバック関数(truncate_title)にありました。
この関数は「129文字以内ならそのまま返す」実装だったため、元のタイトルがもともと129文字以内だった場合、
短縮生成に失敗するとフォールバックが元のタイトルをそのまま返してしまい、Descriptionと完全一致するという
抜け穴になっていました。
対策:最終セーフティネットとして差分を強制する
生成プロセスを分けるだけでは100%の再発防止にならないと判断し、 「Image NameとDescriptionが完全一致していた場合、Description側の末尾を1段階だけ調整する」 という最終チェックを追加しました。ピリオドが連続していれば1つ減らし、無ければ追加する、 という単純なルールですが、Dreamstime側のアップロードエラー(タイトルと説明文の重複禁止)を確実に回避できます。
Dreamstimeの「生成AI」カテゴリを必須化
実際の申請画面を確認していただいたところ、AI生成画像であることを示すため、 Category 1〜3のいずれかに必ず「Illustrations & Clipart → Generative AI」を含める必要があることがわかりました。 カテゴリ自動判定のロジックに、この必須カテゴリを強制的に組み込む処理を追加しています。
- 3枠のうち空きがあれば、そこに追加
- 3枠すべて埋まっている場合は、最も確信度の低い3枠目を「生成AI」に差し替え
stockphoto.jsonにis_ai_generatedという設定を追加し、オンオフを切り替えられるようにしました
(AI生成でない素材を扱う場合は0に変更できます)。なお123RFにはカテゴリ列自体が無いため、この対応はDreamstime専用です。
Ollamaが全リクエストで500エラーになった話
ある日の実行で、画像・動画すべての行でタイトル・説明文・キーワードが完全に空になる現象が発生しました。 最初はコードのバグを疑いましたが、ログを確認すると原因は一目瞭然でした。
Ollama error: 500 Server Error: Internal Server Error for url: http://localhost:11434/api/generateタイトル生成だけでなく、NGチェック(指・目・ロゴ判定)まで、プロンプト内容に関係なく Ollamaサーバー自体が全リクエストに対して500エラーを返していたことが確定しました。 前日のログでは同じスクリプトで正常にタイトル・キーワードが生成できていたため、コード側の問題ではないと判断できました。
結論としては、メモリ不足が原因でした。ブラウザ(後述のStreamlitダッシュボード)を閉じたところ、Ollamaが復旧し、 再処理は正常に完了しました。長時間バッチを回す際は、他の重い処理(動画アップスケール等)やブラウザタブのメモリ消費にも 注意が必要だと再認識させられた一件でした。
おまけ:Streamlitダッシュボードのブラウザフリーズ対策
このOllama 500エラーの調査中、副産物として「長時間バッチ実行中にブラウザタブがフリーズする」という
別の不具合も見つかりました。バッチの進捗ログをStreamlit上にリアルタイム表示する処理で、
2秒間隔のポーリングのたびにst.iframe()でログ表示用のiframeを完全に作り直していたことが原因でした。
複数フェーズの長時間バッチでは、この再生成が数百〜数千回発生し、ブラウザのDOM・メモリを
圧迫していたと考えられます。st.iframeをやめて、既存のCSSクラスとst.markdownによる
軽量な描画に置き換え、さらに自動スクロール用のJS実行(=毎回iframeが必要になる要因)も廃止し、
ログボックスの表示高さにちょうど収まる行数だけを表示する方式に変更しました。
FAQ
123RFのCSVフォーマットもDreamstimeと同じですか?
異なります。123RFはoldfilename・123rf_filename・description・keywords・countryの5列とシンプルで、 カテゴリ列自体がありません。ファイル名は元のファイル名をそのまま流用し、countryは固定値(JP)を出力しています。
キーワードが「1. Woman with」のような文章の断片になる問題はどう直しましたか?
4語以上のフレーズを丸ごと破棄すると空になりやすいため、ストップワードを除いた実質的な単語を 個別キーワードとして抽出する方式に変更しました。あわせて番号表記の除去、括弧の除去、 フレーズと単体語の重複解消も行っています。
Ollamaが全リクエストで500エラーになったのはコードのバグですか?
いいえ、ログで確認したところPythonコード側の問題ではなく、Ollamaサーバー自体が /api/generateへの全リクエストに対して500 Internal Server Errorを返していました。 メモリ不足が原因で、ブラウザ(Streamlitダッシュボード)を閉じることで解消しました。
実際の運用
DreamstimeはAI画像において人物が入っていると確実にNGになります。また123RFはなんでもOKです。 以上の背景もあるため、Adobeストックフォトをこれまで通りの運用を行いつつ、2週に1回程度 貯まった画像データを Dreamstimeや123RFのサイトにアップロードしています。両サイト共に審査申請を行える画像数はかなり多いため、 Adobeストックフォトのように申請できない!といった事象にはほぼ遭遇しないと思います。