📌 後編への案内
本記事公開後、123RF申請用CSVの追加と、実運用で見つかったキーワード・タイトル生成まわりの不具合修正を行いました。内容が多いため、続きは 後編(0032)にまとめています。あわせてご覧ください。
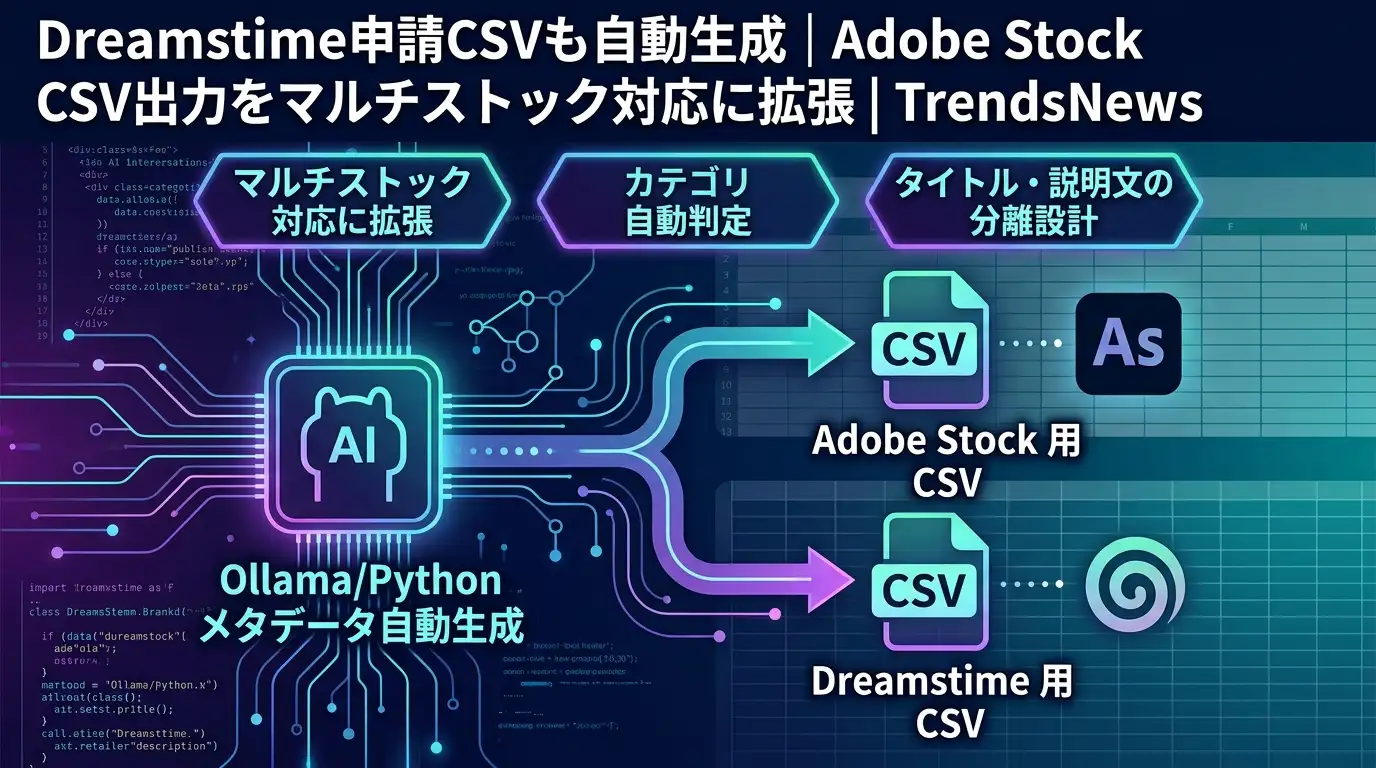
前記事(003)では、OllamaでAdobe Stock申請用のタイトル・キーワードを自動生成し、CSVとして出力する仕組みを構築しました。 本記事はその追加実装として、同じ処理の中でDreamstime申請用CSVも同時に出力できるようにした拡張内容を紹介します。 Adobe Stockに続けてDreamstimeにも同じ画像・動画素材を投稿することを考え、「1回の解析で2サイト分の申請データが揃う」ことを目指しました。
本記事の位置づけ(フロー④2-6の拡張)
フロー上の位置づけは003と同じ「④2-6 メタデータ生成」です。処理自体を新設したわけではなく、
既存のstock_analyzer.py(画像用)とvideo_analyzer.py(動画用)の中に、
Dreamstime向けCSV出力の分岐を追加した形になります。バッチファイルの操作手順や、
フェーズ1(CLIP処理)→フェーズ2(Ollamaでのメタデータ生成)という2段構成の設計も変更していません。
- Adobe Stock用CSV:
adobe_stock_upload.csv/adobe_stock_upload_video.csv(既存) - Dreamstime用CSV:
adobe_stock_upload_dreamstime.csv/adobe_stock_upload_dreamstime_video.csv(今回追加)
ファイル名にAdobeの名残がありますが、既存の命名規則に合わせているためこのままにしています。 出力先・列構成が異なるだけで、処理対象の画像・動画・生成されるタイトルやキーワードの元データは共通です。
Adobe StockとDreamstimeでCSVフォーマットが違う
両サービスのテンプレートを見比べると、そもそも列構成からして別物でした。Adobe Stockは Filename・Title・Keywords・Category・Releasesの5列とシンプルですが、 Dreamstimeは以下のような構成です。
| 列名 | 内容 |
|---|---|
| Filename | ファイル名 |
| Image Name / Video Name | タイトル |
| Description | 説明文 |
| Category1~3 | カテゴリID(最大3つまで階層カテゴリを指定可能) |
| keywords | キーワード(カンマ区切り) |
| Free / W-EL / P-EL / SR-EL / SR-Price / Editorial | ライセンス関連設定 |
| MR doc Ids / Pr Docs | モデルリリース・プロパティリリースの書類ID |
Dreamstimeの一括アップロード用CSVテンプレートは以下のようなイメージです。
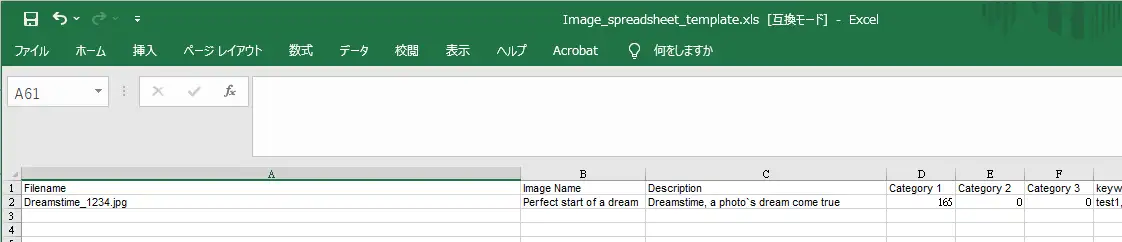
Adobe用に生成した英語タイトルとキーワードはそのまま流用できるものの、 「タイトルと説明文の分離」「カテゴリの3階層対応」「ライセンス項目の初期値」という、 Adobe側の実装にはなかった要素への対応が必要になりました。
Dreamstimeの申請のやり方|182カテゴリを自動判定するキーワード辞書
Dreamstimeのカテゴリテンプレートを確認したところ、画像用・動画用ともに同一の182カテゴリが定義されていました (例:「People → Women」「Nature → Landscapes」「Business → People」など、大分類+中分類の階層構造)。 Adobe側では「人物・自然・ビジネス・食べ物・動物」など数個の大まかな分類で済んでいましたが、 Dreamstimeはこの粒度では申請画面と対応が取れません。
182カテゴリとは下図のようにDreamstime側が定義しています。
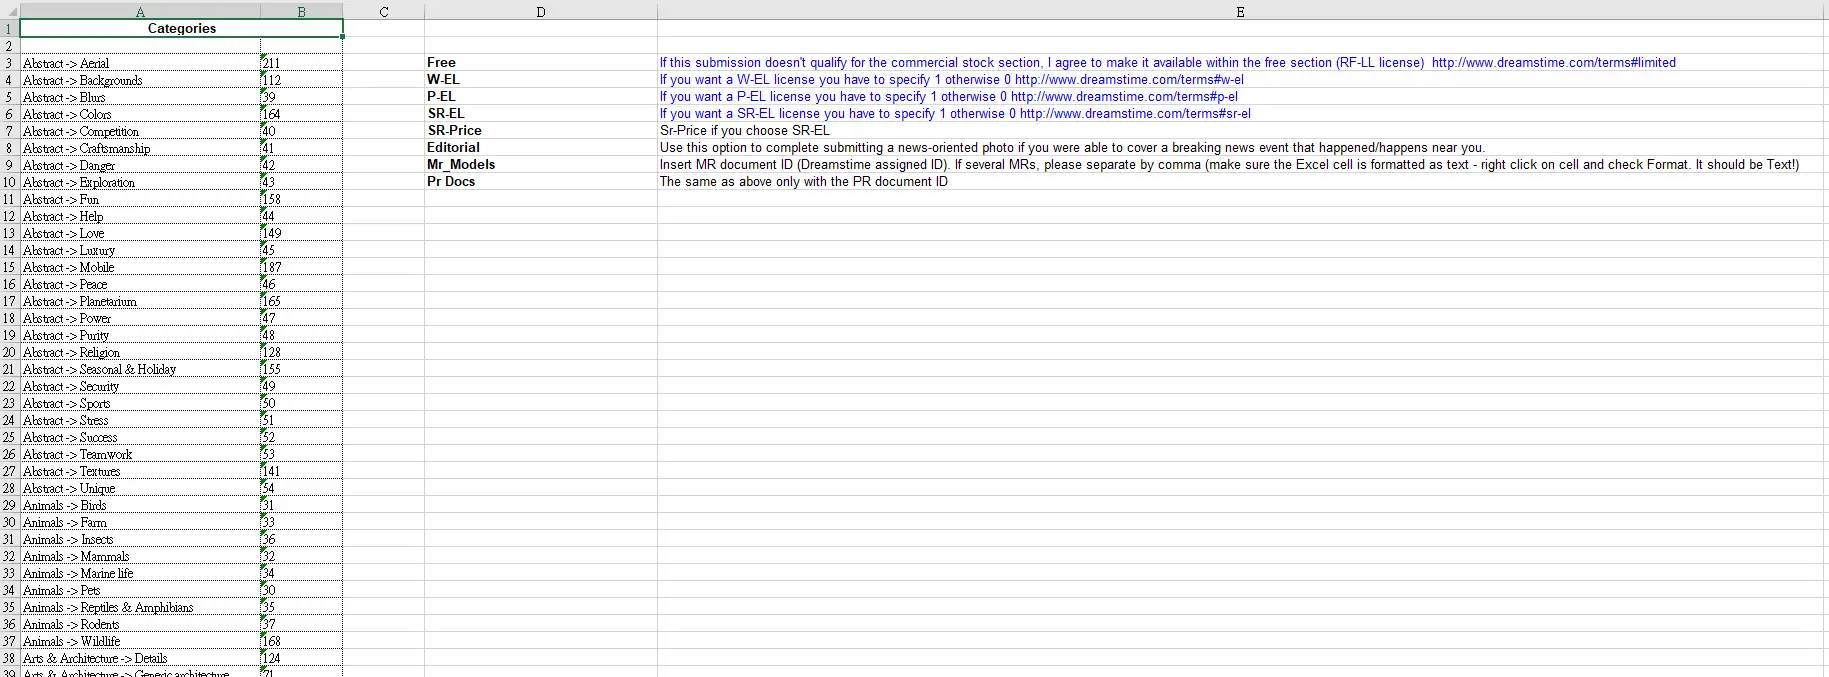
そこで、全182カテゴリそれぞれにキーワード辞書を持たせ、生成済みのタイトル・キーワードとの一致数で スコアリングする方式にしました。カテゴリ名自体から抽出した単語(例:"Nature -> Landscapes" なら nature / landscapes)に加えて、実際の写真で使われそうな同義語(sunset、mountain、riverなど)を 手作業で追加しています。
カテゴリ判定の処理フロー
- タイトル・キーワードのテキストと、各カテゴリのキーワード集合を突き合わせる
- 単語一致は+1点、フレーズ一致(スペースを含む語)は+2点で加点
- 人物が写っている場合はPeople系カテゴリに補正点を加算
- スコア上位3件を Category1・2・3 に割り当てる(一致がなければ空欄のまま)
カテゴリはCategory1・2・3も入力できる仕様だったため、上位3件まで拾うようにしています。 無理に3つ埋めようとはせず、スコアが0のカテゴリは候補に含めない設計にしています。 誤ったカテゴリを機械的に埋めるより、空欄のまま申請時に人が判断できる状態を優先しました。
詳細なFTPアップロード手順は、公式のDreamstimeへのFTPアップロード手順をご確認ください。
タイトルと説明文を「別の文章」にする
実装当初、Image NameとDescriptionの両方に同じAdobe用タイトルをそのまま流用していました。 しかし実際に申請してみると同一値の場合はエラーで弾かれることが分かりました。 単純に文字数で切り詰める案も考えましたが、単語や文の途中で切れてしまうと不自然な文章になってしまいます。
最終的に採用したのは、Image NameとDescriptionをそれぞれ別の生成プロセスにする方法です。
| 項目 | 文字数制限 | 生成方法 |
|---|---|---|
| Image Name(タイトル) | 129文字以内 | 画像を見て「129文字以内で完結する1文」をOllamaに個別リクエスト |
| Description(説明文) | 制限なし | Adobe用に生成した元のタイトルをそのまま使用 |
Image Nameの生成が失敗した場合や、どうしても129文字に収まらない場合のみ、 ピリオド→カンマ→接続語(with / and / inなど)→単語区切りの順で自然な切れ目を探して短縮する フォールバック処理を用意しています。あくまで非常時のセーフティネットという位置づけで、 基本的にはOllamaによる短文生成を優先しています。
設計のポイント:生成過程を分ければ結果は自然に変わる
「同じ文章を切り詰めて2種類作る」のではなく、「別の指示で2回生成する」ことで、 タイトルと説明文が結果的に異なる文章になります。無理に差分を作るロジックを書くより、 生成プロセス自体を分ける方がシンプルで破綻しにくいと感じました。
ライセンス関連項目はJSON設定に集約
Free・W-EL・P-EL・SR-EL・SR-Price・Editorial・MR doc Ids・Pr Docsといったライセンス関連の列は、 画像1枚ごとに内容を見て個別判断すべき項目のため、自動で正しい値を決めることはできません。 そこで、一律の初期値をstockphoto.jsonに持たせておき、CSV出力時に流し込む方式にしました。 これまでの実装方針(設定はコードでなくJSONに集約する)を踏襲した形です。
dreamstime_defaults(画像用の例)
free:無料(RF-LL)ライセンスで提供するかw_el/p_el/sr_el:拡張ライセンスの付与有無sr_price:SR-EL選択時の価格editorial:エディトリアル素材として登録するかmr_doc_ids/pr_docs:モデル・プロパティリリースの書類ID
申請画面には「この投稿が商用ストック素材の要件を満たさない場合、無料セクションで公開することに同意する」 「このファイルはDreamstime.comにのみアップロードする」という2つのチェックボックスもありましたが、 後者はCSVテンプレートに対応する列がなく、Web画面だけの設定であることを確認したため、未チェックのまま (CSV側では対応不要)としています。前者はFree列がそのまま対応しているため、既存の実装で問題ありません。
実際にDreamstimeへ申請してみた結果
実装後、実際にAI生成画像を1枚アップロードして動作確認を行いました。ベンチで読書をする女性の 秋の紅葉イラストを申請したところ、タイトル・説明文・キーワード・カテゴリ(人々 → 女性)が 自動入力された状態で申請画面が開き、手動での修正はほぼ不要でした。
キーワードについてはAdobe用に生成した内容をそのまま流用していますが、単語単位で分割されているため Dreamstime側のキーワード入力欄にもそのまま反映されています。カテゴリについても、辞書のマッチングが 機能していることを確認できました。
今後の課題
キーワードベースのカテゴリ判定は、あくまで一致度によるスコアリングのため完璧ではありません。 今後実際に運用していく中で、「このカテゴリがよく外れる」「このキーワードを追加したい」といった ズレが出てくることが予想されるため、辞書を継続的にメンテナンスしていく必要があります。 また、現状はDreamstimeのみの対応ですが、他のストックフォトサイトへの申請が増えた場合も、 同じ設計(CSVフォーマットの差分だけを吸収する)で横展開できると考えています。
FAQ
Adobe Stock用とDreamstime用でCSVフォーマットは同じですか?
異なります。Adobe StockはFilename・Title・Keywords・Category・Releasesの5列ですが、 DreamstimeはImage Name・Description・Category1~3・ライセンス関連列など列数も構成も別物です。 そのため専用のCSV出力処理を追加しました。
Dreamstimeの182カテゴリはどうやって自動判定していますか?
カテゴリごとにキーワード辞書を作成し、生成済みのタイトル・キーワードとの一致数でスコアリングして 上位3件をCategory1~3に割り当てています。完璧ではないため、運用しながら辞書を随時調整しています。
タイトルと説明文が同じ内容になってしまう問題はどう解決しましたか?
Description欄には元のタイトル生成結果をそのまま使用し、Image Name(タイトル)欄だけは 129文字以内に収まる短い文をOllamaに別途生成させることで、両者が自然に異なる文章になるようにしました。